歴史学者のためのOCRプラットフォーム。
Bandit は漢文テキストに特化した OCR プラットフォームです。研究者が修正した結果がモデルの知識となり、次のページからより正確に読み取ります。
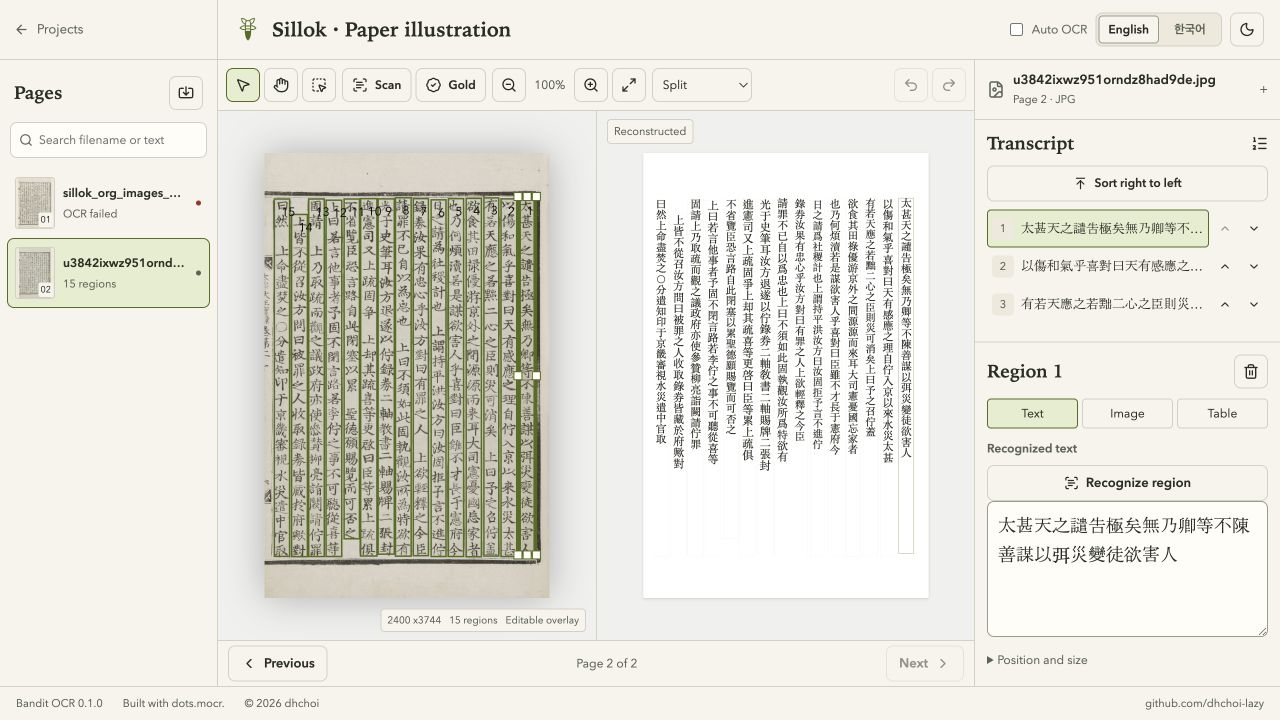
ふつうの OCR が諦めるページのために。
特徴 1. 漢文テキストに特化
縦の行、割注、摩耗した活字、1 ページに数十行。現在は朝鮮の前近代資料で学習しており、対象はリリースごとに広がります。
特徴 2. 自分のコンピュータで動作
認識は自分の GPU で行われ、何もアップロードされません。未公開の史料や個人の記録がコンピュータの外に出ることはありません。
特徴 3. 使うほど賢くなるモデル
修正したページを Gold にしてモデルを学習させると、その修正が個人用アダプタとなり、次の認識から反映されます。
特徴 4. そのまま使えるエクスポート
JSON、JSONL、CSV、Markdown、またはプロジェクト全体のバンドルを、好きな場所に保存します。
スキャンから校正済みテキストへ。
取り込み
ページ画像や PDF をローカルのプロジェクトとして開きます。PDF は自分のコンピュータで画像に変換されます。
認識
1 ページずつ、またはプロジェクト全体を実行します。行を読むたびに枠が現れ、エディタは応答し続けます。
校正
枠を動かし、文字を直し、行の順序を変え、元に戻します。正しければページを Gold にします。
エクスポート
JSON、JSONL、CSV、Markdown、またはプロジェクトのバンドルを、通常の保存ダイアログから書き出します。
動作環境
- Mac
- Apple silicon(M1 以降)、macOS 14 以降
- メモリ
- 最低 16 GB。32 GB 以上ではモデルをフル精度で実行します。
- ディスク
- 約 7 GB: アプリと、一度だけダウンロードする OCR モデル
- Windows
- 未ビルド。CUDA 対応の NVIDIA GPU を予定。
- ネットワーク
- 初回起動時のモデルのダウンロードのみ
ダウンロード
ダウンロード