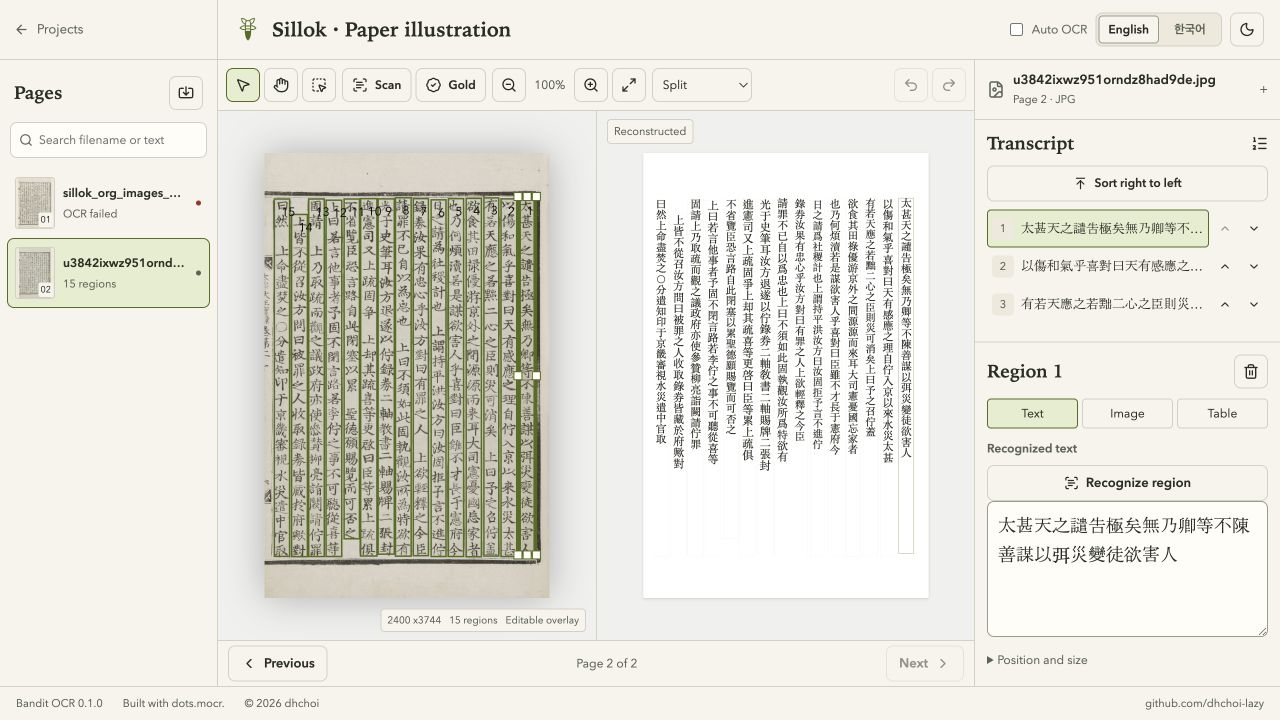
为一般 OCR 放弃的页面而生。
特色 1. 专为文言文文本打造
竖行、夹注、磨损的字体、一页数十行。目前以朝鲜前近代资料训练,覆盖范围会随每次发布扩大。
特色 2. 在你自己的电脑上运行
识别在你的 GPU 上进行,不上传任何内容。未公开的史料与个人记录不会离开这台电脑。
特色 3. 越用越聪明的模型
将修正好的页面标为 Gold 并训练模型,你的修正会成为个人适配器,下一次识别立即生效。
特色 4. 随时可用的导出
JSON、JSONL、CSV、Markdown,或整个项目的打包文件,存到你选择的位置。
从扫描到校对完成的文字。
导入
以本地项目打开页面图片或 PDF。PDF 在你的电脑上转为图片。
识别
逐页或整个项目运行。每读完一行就出现框线,编辑器保持响应。
校对
移动框线、修正文字、调整行序、撤销。正确后将页面标为 Gold。
导出
JSON、JSONL、CSV、Markdown 或项目打包文件,通过普通的保存对话框输出。
运行需求
- Mac
- Apple silicon(M1 或更新),macOS 14 或更新
- 内存
- 最少 16 GB。32 GB 以上以全精度运行模型。
- 磁盘
- 约 7 GB:应用程序加上只下载一次的 OCR 模型
- Windows
- 尚未构建。计划支持 CUDA 的 NVIDIA GPU。
- 网络
- 仅首次启动下载模型时需要
下载
下载