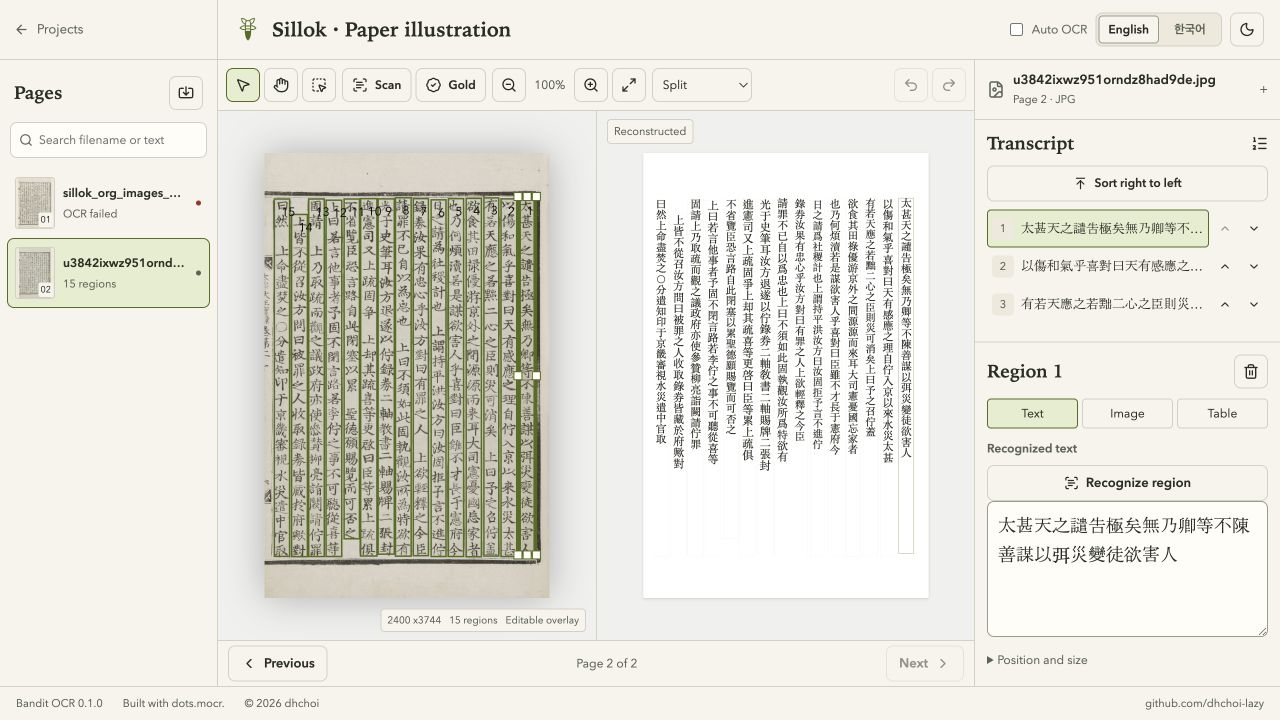
為一般 OCR 放棄的頁面而生。
特色 1. 專為文言文文本打造
直行、夾注、磨損的字體、一頁數十行。目前以朝鮮前近代資料訓練,涵蓋範圍會隨每次發布擴大。
特色 2. 在你自己的電腦上執行
辨識在你的 GPU 上進行,不上傳任何內容。未公開的史料與個人記錄不會離開這台電腦。
特色 3. 越用越聰明的模型
將修正好的頁面標為 Gold 並訓練模型,你的修正會成為個人適配器,下一次辨識立即生效。
特色 4. 隨時可用的匯出
JSON、JSONL、CSV、Markdown,或整個專案的打包檔,存到你選擇的位置。
從掃描到校對完成的文字。
匯入
以本機專案開啟頁面圖片或 PDF。PDF 在你的電腦上轉為圖片。
辨識
逐頁或整個專案執行。每讀完一行就出現框線,編輯器保持回應。
校對
移動框線、修正文字、調整行序、復原。正確後將頁面標為 Gold。
匯出
JSON、JSONL、CSV、Markdown 或專案打包檔,透過一般的儲存對話框輸出。
執行需求
- Mac
- Apple silicon(M1 或更新),macOS 14 或更新
- 記憶體
- 最少 16 GB。32 GB 以上以全精度執行模型。
- 磁碟
- 約 7 GB:應用程式加上只下載一次的 OCR 模型
- Windows
- 尚未建置。規劃支援 CUDA 的 NVIDIA GPU。
- 網路
- 僅首次啟動下載模型時需要
下載
下載