역사학자만을 위한OCR 플랫폼.
반딧은 한문 텍스트에 특화된 OCR 플랫폼입니다. 연구자가 고친 결과가 모델의 지식이 되어, 다음 페이지부터 모델이 더 정확하게 읽습니다.
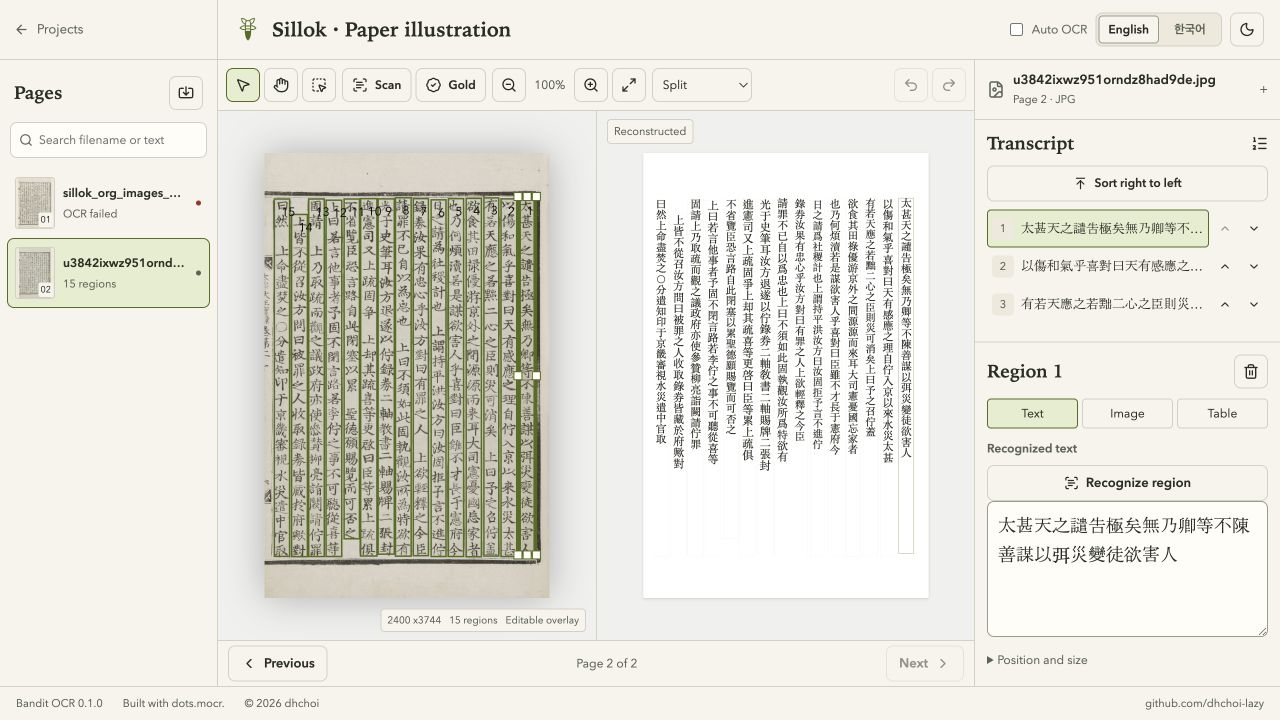
보통 OCR이 포기하는 페이지를 위해 만들었습니다.
특징 1. 한문 텍스트에 특화
세로 행, 세주, 닳은 활자, 한 페이지에 수십 행. 지금은 한국 전근대 자료로 학습했고, 대상 자료는 릴리스마다 넓어집니다.
특징 2. 내 컴퓨터에서 실행
인식은 내 GPU에서 돌아가고 아무것도 올라가지 않습니다. 미공개 사료와 개인 기록이 컴퓨터 밖으로 나가지 않습니다.
특징 3. 쓸수록 똑똑해지는 모델
교정한 페이지를 Gold로 표시하고 모델을 학습시키면, 그 교정이 개인 어댑터가 되어 다음 인식부터 바로 반영됩니다.
특징 4. 바로 쓸 수 있는 내보내기
JSON, JSONL, CSV, Markdown, 또는 프로젝트 전체 번들을 원하는 곳에 저장합니다.
스캔에서 검토된 텍스트까지.
가져오기
페이지 이미지나 PDF를 로컬 프로젝트로 엽니다. PDF는 내 컴퓨터에서 이미지로 변환합니다.
인식
한 페이지씩, 또는 프로젝트 전체를 돌립니다. 행을 읽을 때마다 상자가 나타나고 편집기는 계속 반응합니다.
교정
상자를 옮기고, 글자를 고치고, 행 순서를 바꾸고, 되돌립니다. 맞으면 페이지를 Gold로 표시합니다.
내보내기
JSON, JSONL, CSV, Markdown, 또는 프로젝트 번들을 일반 저장 대화상자로 내보냅니다.
실행 환경
- Mac
- Apple silicon(M1 이후), macOS 14 이상
- 메모리
- 최소 16 GB. 32 GB 이상이면 모델을 전체 정밀도로 돌립니다.
- 디스크
- 약 7 GB: 앱과 한 번 내려받는 OCR 모델
- Windows
- 아직 빌드 전. CUDA를 쓰는 NVIDIA GPU 예정.
- 네트워크
- 첫 실행 때 모델을 받을 때만
다운로드
다운로드